


En Arrival, la película de Denis Villeneuve basada en un relato de Ted Chiang, el desafío no es traducir el idioma de unos alienígenas, sino aceptar algo más incómodo: que esos visitantes perciben la realidad, incluido el tiempo, de una manera radicalmente distinta a la nuestra. Entenderlos no consiste en encontrar el diccionario adecuado, sino en asumir que hay otra forma de comprender el mundo, ajena a la humana y no por ello menos válida.
Sin naves ni heptápodos, llevamos años conviviendo con una versión de ese problema. Hemos construido sistemas que reconocen imágenes, traducen idiomas y sostienen conversaciones, y damos por hecho que, en el fondo, ven el mundo más o menos como nosotros, solo que con más datos y menos cansancio. Pero la inteligencia artificial no percibe una versión borrosa de nuestro mundo, habita uno distinto, tejido con rasgos que nosotros ni siquiera notamos. Y la prueba más elegante de esa extrañeza son los fallos, esos momentos en los que las dos formas de mirar chocan y se ve la costura.
El susurro que para nosotros no existe
En 2013, un equipo de Google, la Universidad de Nueva York, la de Montreal y Facebook, con Christian Szegedy al frente, hizo un descubrimiento desconcertante. A cualquier fotografía bien clasificada se le podía sumar una perturbación minúscula, calculada al detalle, que para una persona la dejaba idéntica pero que hacía que la red la reclasificara por completo. Una imagen corriente pasaba a ser, para la máquina, un avestruz, y lo afirmaba con total seguridad. Llamaron al fenómeno ejemplos antagónicos.
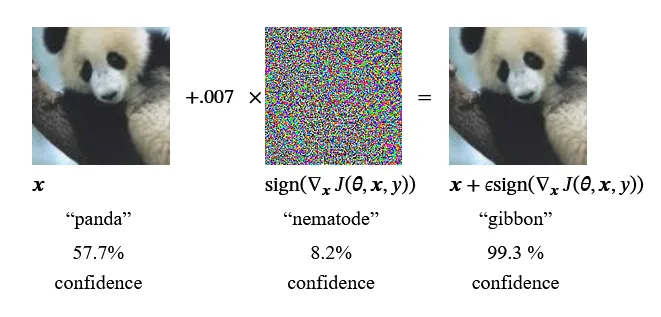
El detalle clave es ese «para una persona». Nosotros no vemos ningún cambio; la máquina ve otra cosa entera. El caso más famoso lo firmó poco después Ian Goodfellow: partiendo de un panda que la red reconocía con un 57,7 % de confianza, le añadió una capa de ruido imperceptible y el modelo pasó a ver un gibón con un 99,3 %. Para explicarlo, los autores señalaron algo contraintuitivo: la culpa no es de que estas redes sean demasiado complejas, sino de que se comportan de forma demasiado lineal en espacios de muchísimas dimensiones. En ese territorio, invisible para la intuición humana, muchos empujones diminutos suman un vuelco. La máquina no vive en nuestro espacio de tres dimensiones y sentido común, sino en otro donde esas reglas mandan.
Un leopardo en la nieve del televisor
Si el avestruz muestra que lo idéntico para nosotros puede ser distinto para la máquina, el trabajo de la Universidad de Wyoming enseñó el reverso: lo que para nosotros no es nada, para ella puede ser algo nítido. En 2015, el equipo de Anh Nguyen, Jason Yosinski y Jeff Clune fabricó patrones abstractos y puro ruido visual, imágenes sin ningún sentido para un ojo humano, y consiguió que redes de primera fila las identificaran como un guepardo o un pavo real con un 99,99 % de confianza. Donde tú ves la estática de un televisor mal sintonizado, el modelo ve, sin titubear, un león.
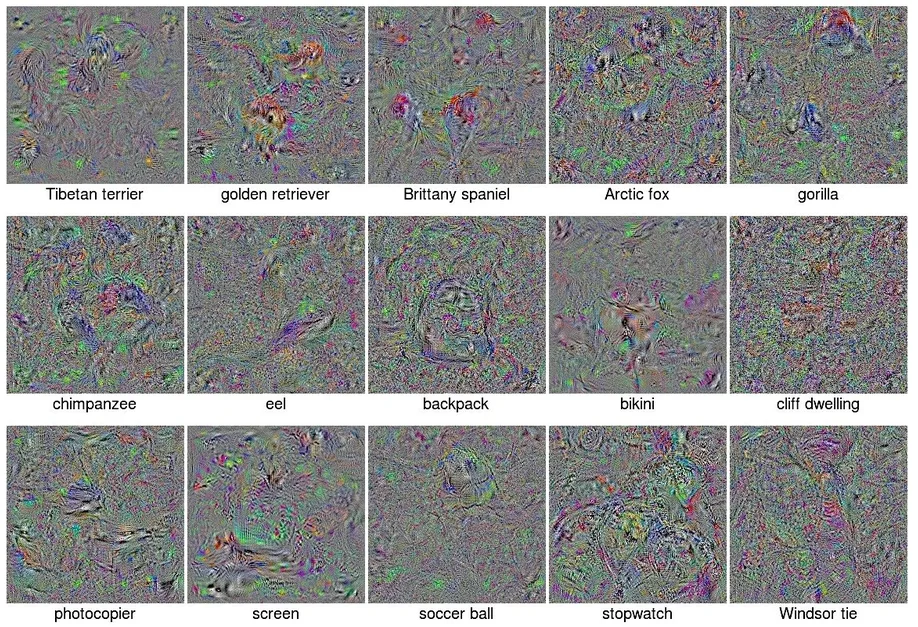
No son dos versiones de la misma escena, son dos mundos perceptivos que apenas se solapan. Y para medir la distancia entre ambos basta un dato: en ocasiones alcanza con cambiar un solo píxel de una imagen para que la máquina cambie de opinión, algo que a nuestra vista ni le va ni le viene. Un píxel que a nosotros no nos dice nada puede ser, para ella, la diferencia entre un barco y un leopardo.
No es un fallo, es su forma de mirar
Durante años esto se trató como una avería a reparar. La lectura más honda llegó en 2019, de un grupo del MIT que le dio la vuelta al problema en un artículo cuyo título ya es una declaración de principios.
«Los ejemplos antagónicos no son errores, son rasgos».
Andrew Ilyas y colaboradores (MIT), 2019
Su tesis es la que sostiene todo este artículo. Esas perturbaciones explotan patrones que existen de verdad en los datos y que sirven para acertar, solo que son frágiles e invisibles para nosotros. La red no se equivoca por torpeza: atiende a señales reales, texturas y microcorrelaciones que a nuestro cerebro le pasan desapercibidas porque nunca las necesitó para reconocer un gato. La máquina no ve peor que nosotros. Ve otra cosa. Ha aprendido a apoyarse en rasgos del mundo que están ahí, pero que caen fuera de nuestra experiencia, del mismo modo que un perro habita un universo de olores que a nosotros nos resulta inaccesible.
El caballo que sabía contar
Que un sistema resuelva bien una tarea no significa que la entienda como nosotros. Lo ilustra una vieja historia: a principios del siglo XX, un caballo alemán llamado Hans el Listo parecía sumar y restar dando golpes de casco. En realidad no calculaba, leía los gestos involuntarios de su entrenador, que se relajaba al llegar al número correcto. Acertaba sin comprender la pregunta.
Las redes neuronales tropiezan con la misma piedra tan a menudo que los investigadores la llaman, precisamente, el efecto Hans el Listo. En un caso célebre, un sistema clasificaba fotos de caballos con gran acierto, pero no miraba al animal: se fijaba en una diminuta etiqueta de origen presente en cerca de una quinta parte de esas imágenes. Al borrarla, el caballo se esfumaba; al pegarla sobre un coche, el coche se volvía caballo. A eso se le llama aprendizaje por atajos, y su lección encaja con la idea de fondo: la máquina construye sus propios conceptos, y esos conceptos no son los nuestros aunque den la misma respuesta. Es el mismo abismo que asoma cuando los modelos afirman ver cosas que no existen.
La misma extrañeza, ahora en el lenguaje
Podría pensarse que esto es cosa de la visión, pero los grandes modelos de lenguaje han heredado la misma rareza, solo que con palabras. La versión conocida es la inyección de prompts: colar instrucciones dentro de un texto que el modelo va a leer para que las obedezca. Cuando esas órdenes no las escribe el usuario, sino que el asistente las encuentra por su cuenta en una web o un documento, hablamos de inyección indirecta, y difumina una frontera, la que separa los datos de las instrucciones, que para nosotros es obvia y para el modelo no lo es tanto. No es teoría: ya vimos cómo una simple invitación de calendario puso en jaque a Gemini.
El paralelismo con las imágenes es casi perfecto. En 2023, un equipo de la Universidad Carnegie Mellon generó de forma automática una ristra de caracteres aparentemente sin sentido que, añadida a una petición prohibida, desactivaba las defensas del modelo. Para un lector humano, galimatías; para la máquina, una llave maestra. Y, como con el ruido que se convertía en leopardo, esa llave era universal y transferible: afinada sobre modelos abiertos, abría también las cerraduras de sistemas comerciales como ChatGPT, Claude o Bard. Distintas mentes artificiales compartían la misma grieta perceptiva, una que a nosotros nos resulta invisible.
Cuando las dos formas de ver chocan
Mientras esta brecha se queda en la pantalla, es un enigma fascinante. El problema es que ya no se queda. Con unas pegatinas bien puestas sobre una señal de STOP, un sistema de reconocimiento de señales de tráfico puede leerla como un límite de velocidad, aunque para cualquier peatón siga siendo un STOP con calcomanías. Se han diseñado monturas de gafas que burlan el reconocimiento facial, y se ha demostrado en la revista Science que es posible retocar una imagen médica de forma inapreciable para cambiar un diagnóstico. Donde nuestros ojos no ven nada raro, la máquina ve una orden distinta.
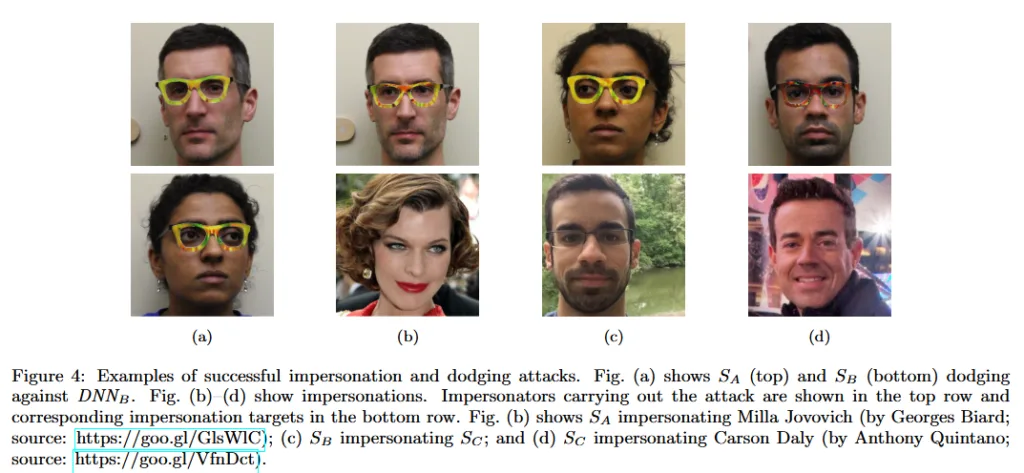
Contra esto existe una defensa parcial, el entrenamiento adversario, que consiste en generar estos engaños durante el aprendizaje para que el modelo aprenda a resistirlos. En cierto modo, es enseñarle a mirar un poco más como nosotros. Pero tiene un precio comprobado: un modelo más difícil de engañar tiende a acertar algo menos en condiciones normales, como si acercarlo a nuestra forma de ver le restara parte de su agudeza estadística. El campo avanza así, en una carrera sin meta entre ataques y defensas, porque la extrañeza no es un bug pegado por fuera, sino el modo en que estos sistemas extraen sentido del mundo.
Comprender de otra manera
Volvamos a Arrival. Lo que la película plantea no es que los alienígenas sean tontos o defectuosos por no pensar como nosotros, sino que su inteligencia es de otra clase, y que el error humano es medirlos con nuestra vara. Con la IA cometemos justo esa equivocación al revés: como responde en nuestro idioma y acierta en nuestras tareas, damos por hecho que comprende como nosotros. Los ejemplos antagónicos son el pinchazo que deshincha esa ilusión. Un sistema al que un poco de ruido imperceptible convence de que un panda es un gibón no sabe qué es un panda al modo en que lo sabe un niño; ha tejido una correlación asombrosamente útil entre configuraciones de datos y etiquetas, pero su concepto de panda está hecho de otra materia.
Esto no rebaja el logro, que es enorme, pero cambia la pregunta. Durante mucho tiempo nos preguntamos si las máquinas llegarían a pensar como los humanos. Quizá la cuestión más interesante, y más urgente ahora que conducen, diagnostican y deciden, sea otra: cómo convivir con una inteligencia que percibe y comprende de una forma que no es la nuestra, aprovechando su mirada distinta sin olvidar nunca que es distinta. Entenderla, como a los visitantes de Ted Chiang, no será dar con el diccionario correcto, sino aceptar que hay más de una manera de leer el mundo.
La imagen de representación de este artículo es un fotograma de la película Arrival (Denis Villeneuve, 2016), distribuida por Paramount Pictures.

